
なぜ、このプログラムなのか
私たちが取り組む課題
保険業務の自動化が進むにつれ、構造化されたデータ項目だけをもとに判断されるケースが増えています。しかし、何かがおかしいことを示す証拠は、通常、そうした項目の周辺にあります。電話での会話、写真、メモ、書類などです。
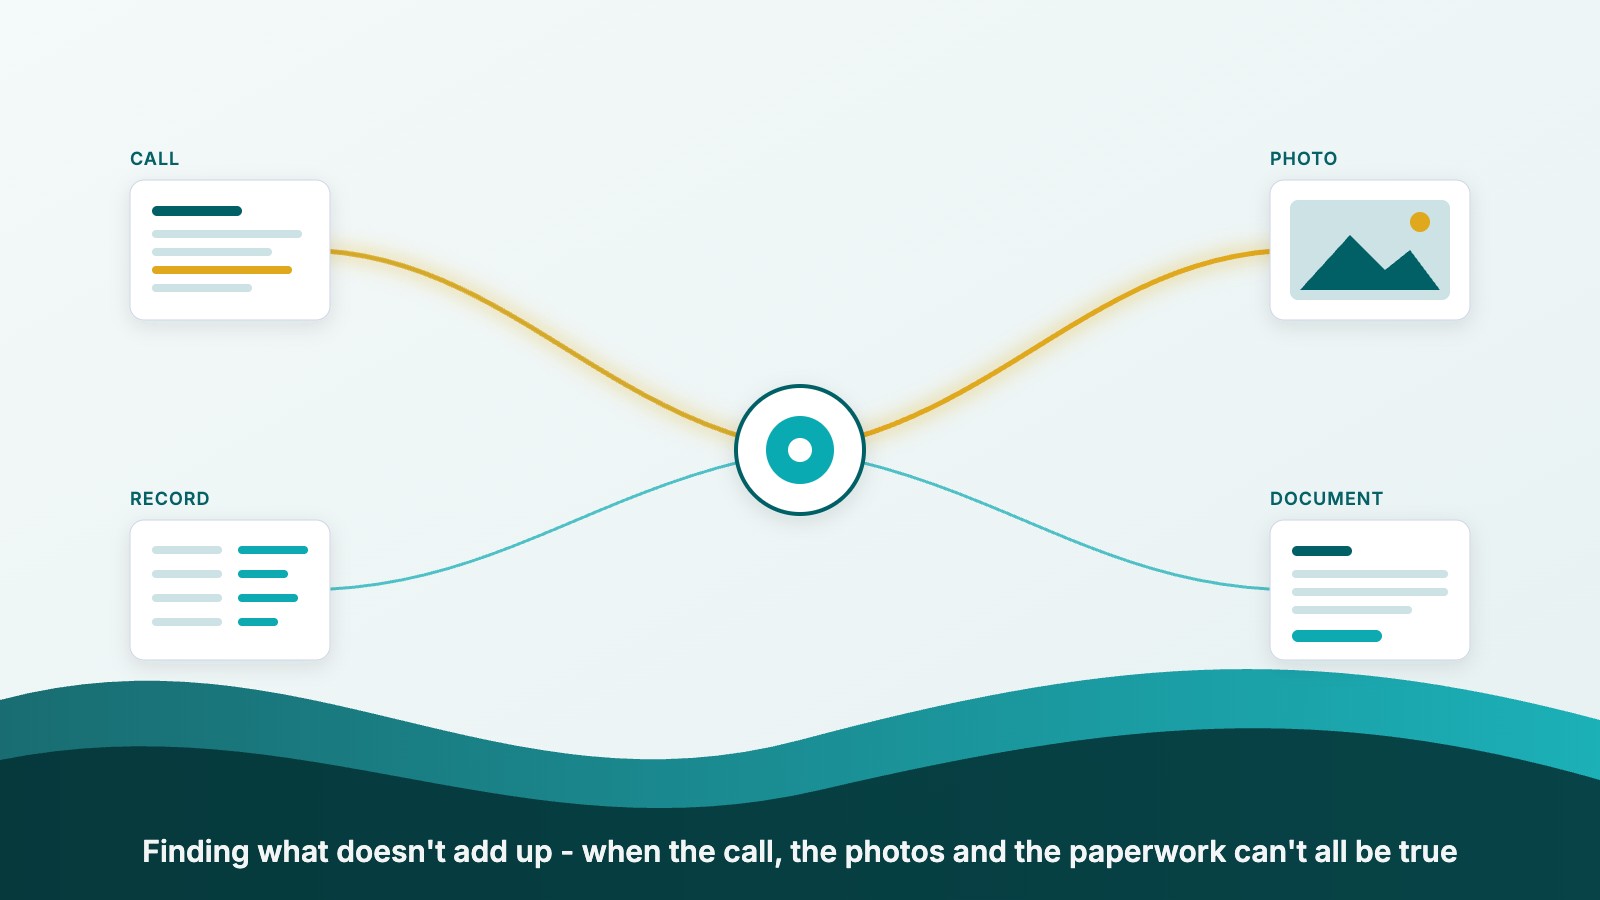
たとえば、ある人が「停車していた」と電話で説明している一方で、写真には車両の前方角部に斜め方向の損傷が写っているとします。どちらか一方だけを見れば、間違いとは言えません。経験豊富な担当者なら、こうしたことに数秒で気づきます。そして、そのためのルールが誰かによって書かれているわけでもありません。
既製の「異常検知」は、単一の指標における外れ値を探すものであり、このようなケースを完全に見逃してしまいます。人が判断に介在しなくなれば、こうした気づきも失われます。私たちは、それを再構築する必要があります。
私たちのビジョン
自動化されたすべての判断について、優れた専門家なら行ったであろう精査を実現すること。すべての証拠を総合的に評価し、矛盾を明らかにし、その判断に至った理由を示します。
私たちの独自性
私たちが「異常」と呼ぶものには、明確な定義があります。それは、複数の証拠を横断して初めて見つけられる矛盾であり、実際の判断を変えるものです。
これは、クラウドの機能として購入できるものではありません。プラットフォームが「異常検知」として提供しているものは、単一の指標に対する統計分析です。
私たちの取り組みは、保険の実際の業務の中から始まります。保険金請求、不正、リスクの領域で、実際のデータ、実際のワークフロー、そして導入先となる環境を用います。
そこから、電話、書類、画像、記録をひとつの情報として読み取り、その情報の中に成り立たないものがないかを検証するという、難しい部分を構築します。
オックスフォードの研究コミュニティも、すぐ近くにあります。

ベルナルド・ペレス・オロスコ
AIデリバリー担当ディレクター
アナンド・ラムクマール
機械学習サイエンティスト
パトリック・タニー
機械学習サイエンティスト

ディエゴ・セルベラ
機械学習サイエンティスト
フランチェスカ・ロンチ
機械学習サイエンティスト
アレックス・コンスタンティン
プロジェクトリード 兼 機械学習エンジニア
ステフ・クラックスマン
シニアソフトウェアエンジニア
チーム
このプログラムを率い、支えるメンバーをご紹介します。